כאשר ארגונים ניגשים אל פיתוח אפליקציות AI מורכבות, הציפייה היא לזינוק מיידי בפריון. ההבטחה ברורה: עוזרי הקידוד החכמים יכתבו את הקוד השחור, והמפתחים יתפנו לפתרון בעיות לוגיות מורכבות. המציאות, לעומת זאת, נראית אחרת לגמרי. צוותי פיתוח מוצאים את עצמם מבלים שעות ארוכות בתיקון קוד גנרי שלא מתאים לארכיטקטורה הארגונית, מוחקים הצעות שגויות, ונאבקים ליישר קו עם סטנדרטים פנימיים.
מתוך 22 שנות ניסיון של עידית משען, מומחית תוכנה, בפיתוח מערכות מורכבות, אפיון חווית משתמש UX ופיתוח צד שרת, עולה תמונה ברורה: הבעיה אינה טמונה במודלים עצמם, אלא בהקשר שאנחנו מספקים להם. מודלי שפה גדולים מאומנים על כמות עצומה של נתונים, מה שמייצר פלט שהוא למעשה הממוצע של האינטרנט. הם לא מכירים את מוסכמות השמות הספציפיות שלכם, את מבנה התיקיות הייחודי של הפרויקט, או את האנטי-תבניות שהחלטתם לאסור בארגון.
כאן בדיוק נכנס לתמונה קונספט חדש שדורש התייחסות רצינית, כזה שהופך את ניהול הידע לחלק בלתי נפרד מתהליך הפיתוח.
לולאת התסכול של עוזרי הקידוד
מפתחים שעובדים עם כלי AI חווים תופעה מוכרת המכונה "לולאת התסכול". זה מתחיל בבקשה פשוטה ליצירת פונקציה או רכיב חדש. הכלי מייצר קוד במהירות שיא, והקוד אפילו עובד. אבל מבט מעמיק חושף את הבעיות: הקוד משתמש בספריות שהוצאו משימוש בפרויקט, מתעלם משכבת הגישה לנתונים המותאמת אישית שלכם, ומיישם לוגיקה עסקית ישירות בתוך הבקר (Controller).
התוצאה היא שהמפתח נאלץ לשכתב חלקים ניכרים מהקלט, להסביר למודל שוב ושוב את החוקים המקומיים, ולבזבז זמן יקר על מה שהיה אמור להיות קיצור דרך. ביום 24 בפברואר 2026, ראול גארג, מהנדס ראשי בחברת Thoughtworks מגורגאון שבהודו, הציג במאמר שפורסם פתרון מעשי לבעיה זו. הוא כינה את הגישה בשם Knowledge Priming.
גארג טוען במפורש ב-מאמר המקורי כי הדרך היחידה לעקוף את ברירות המחדל הגנריות של המודלים היא להזין אותם בהקשר איכותי מראש. זהו למעשה יישום ידני של טכניקת RAG (Retrieval-Augmented Generation), שבה אנחנו ממלאים את חלון ההקשר של ה-AI במידע ספציפי לפרויקט לפני שאנחנו מבקשים ממנו לכתוב שורת קוד אחת.
מעבר מהרגלים לתשתית מנוהלת גרסאות
הטעות הנפוצה ביותר של צוותים היא הניסיון לנהל את ההקשר הזה כהרגל אד-הוק. מפתחים שומרים קטעי טקסט ב-Notepad ומדביקים אותם בתחילת כל שיחה עם המודל. הגישה הזו מועדת לכישלון. הרגלים דועכים עם הזמן, מפתחים חדשים לא מודעים אליהם, והמידע הופך למיושן במהירות.
הפתרון הוא להתייחס להקשר כאל תשתית לכל דבר. בדיוק כפי שאנחנו מנהלים גרסאות של קוד, עלינו לנהל גרסאות של מסמכי ה-Priming שלנו בתוך מאגר הקוד (Repository). קובץ ייעודי, השוכן לצד קבצי המקור, מבטיח שהידע נשמר, מתעדכן וזמין לכל חבר צוות ולכל סשן פיתוח. תשתית נשארת יציבה גם כשהצוות מתחלף.
האנטומיה של מסמך הכנה מושלם
האנטומיה של מסמך הכנה מושלם
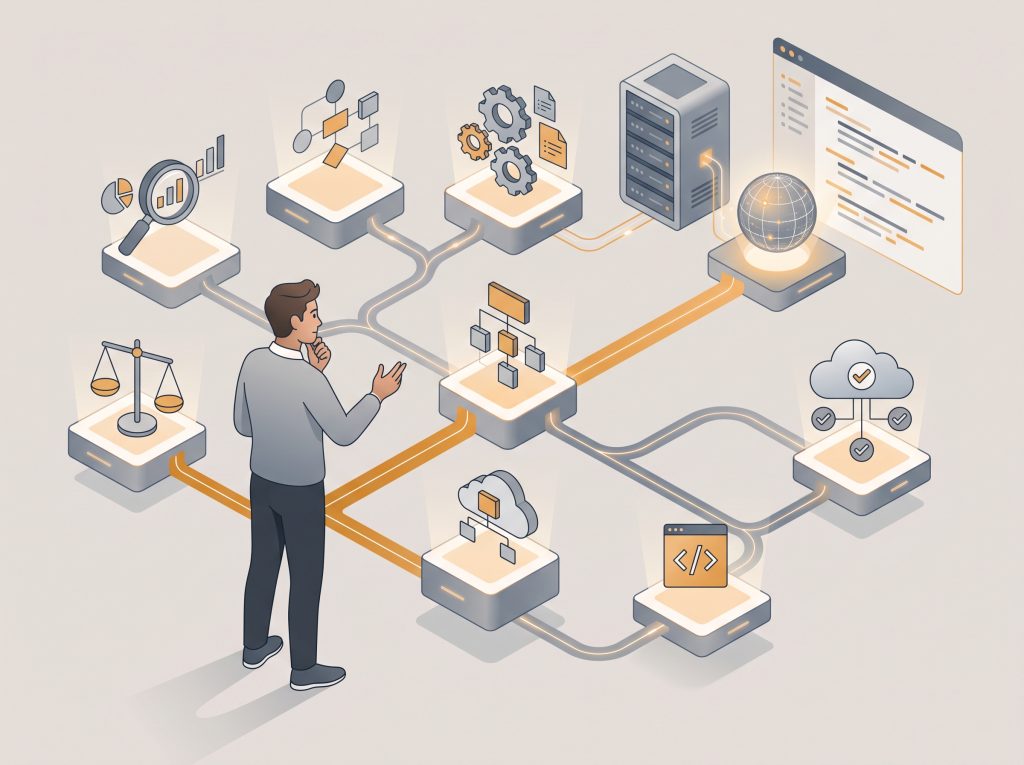
כדי ליישם את הגישה הזו בצורה אפקטיבית, גארג מפרט 7 קטגוריות חובה שצריכות להרכיב את מסמך ה-Priming שלכם. בנייה נכונה של הקטגוריות הללו היא ההבדל בין קוד גנרי לקוד שמרגיש כאילו נכתב על ידי מפתח בכיר בצוות.
1. סקירת ארכיטקטורה ממוקדת
המודל חייב להבין את התמונה הגדולה. האם אתם עובדים בארכיטקטורת מיקרו-שירותים? האם אתם מיישמים Domain-Driven Design (DDD) או Clean Architecture? תיאור קצר וברור של העקרונות הארכיטקטוניים ימנע מה-AI להציע פתרונות מונוליתיים במערכת מבוזרת.
2. מחסנית טכנולוגית וגרסאות ספציפיות
ציון השם של השפה או הספריה אינו מספיק. יש הבדל תהומי בין React 16 ל-React 18, ובין Python 3.8 ל-Python 3.12. ציון הגרסאות המדויקות מונע מהמודל להשתמש בתחביר מיושן או בפונקציות שהוצאו משימוש.
3. מקורות ידע אוצרים
הפניות למסמכי עיצוב פנימיים, סכמות של מסדי נתונים, או תיעוד של ממשקי API חיצוניים שבהם הפרויקט תלוי. זה מאפשר למודל להבין את הסביבה הרחבה יותר שבה הקוד עתיד לפעול.
4. מבנה הפרויקט
היכן שומרים ממשקים (Interfaces)? באילו תיקיות ממוקמים מבחני היחידה? הבנת מבנה התיקיות תאפשר ל-AI להציע נתיבי ייבוא (Import paths) נכונים ולמקם קבצים חדשים במקום הראוי להם.
5. מוסכמות שמות
לכל ארגון יש סטנדרטים משלו. האם אתם משתמשים ב-camelCase או ב-snake_case? האם ממשקים מתחילים באות I? הגדרת החוקים הללו מראש חוסכת עשרות הערות ב-Code Review.
6. דוגמאות קוד חיוביות
אין תחליף לדוגמה טובה. שלבו במסמך קטעי קוד קצרים המייצגים את הסטנדרט המצופה. הראו כיצד נראה בקר תקני, כיצד מטפלים בשגיאות, וכיצד רושמים לוגים במערכת שלכם.
7. אנטי-תבניות שיש להימנע מהן
לפעמים חשוב יותר להגיד למודל מה לא לעשות. אם יש לכם חוק שאוסר על קריאות ישירות למסד הנתונים מתוך רכיבי ממשק משתמש, כתבו זאת במפורש. זהו קו הגנה קריטי מפני הצעות קוד מסוכנות.
מתי הגישה הזו קורסת: מלכודת העודף וההקשר המיושן
למרות היתרונות הברורים, קיימים מצבים בהם השקעה ב-Knowledge Priming אינה נכונה ואף עלולה להזיק. נקודת התורפה המרכזית היא מה שמוגדר כ"מלכודת העודף" (The Too Much Trap). מנהלי פיתוח נוטים לעיתים לדחוס עשרות עמודי תיעוד לתוך מסמך ההכנה, מתוך מחשבה שיותר מידע שווה לתוצאה טובה יותר.
בפועל, עודף מידע מדלל את המיקוד של המודל. כאשר חלון ההקשר מוצף בפרטים שוליים, ה-AI מתקשה לדלות את העקרונות הקריטיים באמת, והביצועים יורדים. בנוסף, חל חוק תפוקה שולית פוחתת: עבור משימות פשוטות מאוד, כמו כתיבת פונקציית עזר לחישוב תאריכים, התקורה של טעינת מסמך ארכיטקטורה שלם פשוט אינה מוצדקת. התיקון הידני יהיה מהיר יותר מהכנת התשתית.
סכנה נוספת היא סיכון ההקשר המיושן. מסמך Priming שלא עודכן לאחר שינוי ארכיטקטוני משמעותי הוא גרוע יותר מהיעדר מסמך לחלוטין. הוא יוביל את כלי ה-AI לייצר קוד שמיושר עם חוקים שכבר אינם רלוונטיים, ויגרום לבלבול רב בקרב צוות הפיתוח.
שלושה תרחישי שימוש מהעולם האמיתי
שלושה תרחישי שימוש מהעולם האמיתי
כדי להבין את העוצמה של הגישה, כדאי לבחון כיצד היא מיושמת בפועל בארגונים שונים:
-
מודרניזציה של מערכות לגאסי: כאשר בנק מחליט לשכתב מערכת ישנה, מסמך ההכנה כולל את המיפוי בין מושגי העבר למושגים החדשים. ה-AI לומד כיצד לתרגם את הלוגיקה העסקית הישנה לארכיטקטורה המודרנית מבלי לאבד את ההקשר הפיננסי.
-
קליטת מפתחים חדשים (Onboarding): מסמך Priming איכותי משרת לא רק את המכונה, אלא גם את האדם. מפתח חדש שמצטרף לצוות יכול לקרוא את המסמך ולהבין מיד את חוקי המשחק, תוך שהוא נעזר ב-AI שמכויל לאותם חוקים בדיוק.
-
אכיפת תקני אבטחה מחמירים: במשרדים ממשלתיים או חברות ביטוח, ניתן להגדיר אנטי-תבניות אבטחה מפורשות במסמך. ה-AI יסרב לכתוב קוד שחושף נתונים רגישים או מדלג על תהליכי אימות, ובכך ישמש כקו הגנה ראשוני.
רגע התובנה: מארכיטקט תוכנה למנהל ידע פעיל
ההבנה העמוקה ביותר שעולה מהטמעת הגישה הזו היא השינוי הדרמטי בתפקידם של מובילים טכנולוגיים. ארכיטקטי תוכנה וסמנכ"לי טכנולוגיה רגילים לתכנן מערכות ולכתוב מסמכי עיצוב המיועדים לבני אדם. כעת, עליהם ללמוד לכתוב תשתית ידע המיועדת למכונות.
המעבר אל פיתוח אפליקציות AI שמבוססות על מודלים גנריים מחייב אותנו לחשוב אחרת. ה-CTO הופך ממתווה דרך פסיבי למנהל ידע פעיל. האחריות שלו היא לוודא שה-AI מבין את ה-DNA של הארגון. זהו שינוי תפיסתי עמוק: במקום להילחם בתוצאות השגויות של המודל, אנחנו מעצבים את נקודת המוצא שלו.
משמעויות פרקטיות: מה עושים מחר בבוקר?
המעבר לגישה מבוססת תשתית אינו דורש השקעה כספית, אלא שינוי תהליכי. הצעד הראשון הוא ליצור קובץ context.md או priming.md בתיקיית השורש של הפרויקט. התחילו בקטן: הגדירו את הארכיטקטורה הבסיסית, רשמו את גרסאות התוכנה, וציינו שתי אנטי-תבניות קריטיות.
הצעד השני הוא לשלב את עדכון המסמך בתהליך ה-Pull Request. בדיוק כפי שאתם דורשים עדכון של מבחני היחידה כאשר קוד משתנה, דרשו עדכון של מסמך ההכנה כאשר הארכיטקטורה מתפתחת. התייחסו למסמך הזה כאל קוד חי לכל דבר.
נקודות מפתח לקחידה
נקודות מפתח לקחידה
- עוזרי קידוד מבוססי AI מייצרים קוד גנרי כברירת מחדל, מה שמוביל ללולאת תסכול ולבזבוז זמן יקר של המפתחים.
- הפתרון הוא Knowledge Priming: הזנת המודל בהקשר פרויקטלי ספציפי לפני תחילת העבודה, כמהלך של יצירה מועשרת באחזור (RAG) ידנית.
- חובה לנהל את ההקשר כתשתית מנוהלת גרסאות בתוך מאגר הקוד, ולא כהרגל אד-הוק של העתק-הדבק.
- מסמך מוצלח יכלול סקירת ארכיטקטורה, גרסאות מדויקות, מוסכמות שמות, דוגמאות קוד ואנטי-תבניות שיש להימנע מהן.
- היזהרו ממלכודת העודף: יותר מדי מידע או מידע מיושן יפגעו בביצועי המודל ויחטיאו את המטרה.
הצעד הבא שלכם
בניית מוצרים דיגיטליים בעידן הנוכחי דורשת הרבה יותר מרק לכתוב קוד. היא דורשת בניית תשתיות ידע חכמות שמאפשרות למכונות ולבני אדם לעבוד יחד בסנכרון מושלם. אם אתם מחפשים שותף טכנולוגי עבור פיתוח אפליקציות AI מתקדמות, כזה שמבין את החשיבות של ארכיטקטורה נכונה וניהול ידע מובנה, הגיע הזמן לבחון את תהליכי הפיתוח שלכם מחדש ולבנות יסודות שיחזיקו מעמד לאורך זמן.
שאלות ותשובות
Knowledge Priming הוא תהליך של הזנת מודל ה-AI בהקשר ספציפי של הפרויקט לפני שמתחילים בתהליך הפיתוח. במקום להסתמך על הידע הגנרי של המודל, אנחנו מספקים לו מידע קריטי כמו ארכיטקטורה, ספריות בשימוש, מוסכמות שמות ואנטי-תבניות. זה משפר את איכות הקוד כי המודל מפסיק לנחש מה הסטנדרטים הארגוניים ומתחיל לייצר פתרונות שמותאמים בדיוק לסביבת העבודה שלכם. התוצאה היא פחות קוד גנרי, פחות תיקונים ידניים מיותרים והתאמה מלאה ללוגיקה העסקית והטכנית של הפרויקט.
הדרך הנכונה לנהל מסמכי Priming היא להתייחס אליהם כאל חלק אינטגרלי מהקוד, ולא כהערות צדדיות. מומלץ לשמור קובץ ייעודי, כמו context.md, בתיקיית השורש של מאגר הקוד (Repository). בצורה זו, המסמך מנוהל בגרסאות יחד עם הקוד, מה שמבטיח שכל חברי הצוות עובדים עם אותן הנחיות מעודכנות. חשוב לשלב את עדכון המסמך בתהליך ה-Pull Request; בכל פעם שמתבצע שינוי ארכיטקטוני משמעותי, יש לעדכן את מסמך ההכנה כדי למנוע מה-AI להציע פתרונות המבוססים על חוקים מיושנים.
הסיכון המרכזי הוא יצירת קוד שאינו תואם את הסטנדרטים הארגוניים או את דרישות האבטחה. מודלים גנריים עלולים להציע ספריות מיושנות, לחשוף נתונים רגישים או ליישם לוגיקה עסקית במקומות שגויים בארכיטקטורה. בנוסף, קיימת סכנת 'הקשר מיושן' – אם מסמכי ההכנה לא מעודכנים, ה-AI ימשיך לייצר קוד לפי חוקים שבוטלו, מה שיוצר בלבול וטעויות קשות לאיתור. לכן, חשוב להגדיר מראש 'אנטי-תבניות' ברורות במסמך ההכנה, שימנעו מהמודל לבצע פעולות מסוכנות או לא רצויות.
השימוש ב-Knowledge Priming אינו מומלץ במשימות פשוטות ונקודתיות, שבהן התקורה של הכנת המסמך עולה על זמן הכתיבה הידני. אם אתם צריכים לכתוב פונקציית עזר בסיסית או לבצע שינוי קטן שאינו דורש הבנה של הארכיטקטורה הכוללת, אין צורך להעמיס על המודל מידע רב. בנוסף, הימנעו מ'מלכודת העודף' – דחיסת עשרות עמודי תיעוד לתוך חלון ההקשר תגרום למודל לאבד מיקוד. ככל שהמידע עמוס ופחות רלוונטי למשימה הספציפית, כך הביצועים של ה-AI ירדו והתוצאות יהיו פחות מדויקות.
הטמעת תשתית Knowledge Priming אינה דורשת השקעה כספית או זמן פיתוח ממושך, אלא שינוי תהליכי בלבד. הצעד הראשון הוא יצירת מסמך ההכנה הראשוני, תהליך שיכול לקחת מספר שעות עבודה של ארכיטקט או מפתח בכיר שמכיר את הסטנדרטים של הפרויקט. לאחר מכן, התחזוקה השוטפת משתלבת בתוך תהליך ה-Code Review הקיים. מדובר בשינוי תרבותי שבו הצוות לומד להתייחס לידע כאל תשתית מנוהלת, מה שחוסך זמן רב בטווח הארוך על ידי מניעת תיקוני קוד חוזרים ונשנים.
השיטה מתאימה במיוחד לפרויקטים מורכבים, מערכות לגאסי בתהליכי מודרניזציה, וארגונים עם סטנדרטים טכנולוגיים מחמירים. היא אידיאלית כאשר יש צורך באכיפת מוסכמות שמות, מבנה תיקיות קבוע או דרישות אבטחה ספציפיות שלא קיימות בתיעוד הציבורי של השפות והספריות. לעומת זאת, בפרויקטים קטנים מאוד או ב-Proof of Concept ראשוני שבו אין עדיין ארכיטקטורה מוגדרת, ייתכן שהשיטה תהיה מורכבת מדי ותגביל את הגמישות הנדרשת בשלבים המוקדמים של המחקר והפיתוח.