שאל כמעט כל צוות פיתוח איך הוא מודד את איכות הבדיקות שלו, והתשובה תגיע מיד: אחוז כיסוי קוד. המדד הזה מופיע כמעט בכל תהליך אינטגרציה רציפה (CI), נאכף דרך שערי איכות, ולרוב נתפס כאינדיקטור מרכזי לבגרות הנדסית בארגון. מנהלים חוגגים הגעה ל-90% או אפילו 100% כיסוי, ורואים במספרים הללו חותמת איכות לבריאות הפרויקט. אבל המספרים האלה מסתירים אמת מטרידה מאוד לגבי המוצר שלכם.
מתוך 22 שנות ניסיון שצברה עידית משען, מומחית תוכנה, בפיתוח אפליקציות ומערכות מורכבות עבור מותגי ענק ומשרדים ממשלתיים, עולה דפוס ברור: חברות משקיעות הון בבדיקות שלא בודקות דבר. צוותים כותבים טסטים רק כדי לרצות את המערכת, ומפספסים את המטרה האמיתית שלשמה התכנסנו.
כדי להבטיח מוצר יציב באמת, שיפור איכות בדיקות תוכנה בעידן ה-AI דורש מאיתנו להפסיק לספור שורות קוד שרצו, ולהתחיל למדוד ביטחון. הגיע הזמן להבין למה אחוזים גבוהים לא מבטיחים לכם שקט נפשי.
הבעיה: האשליה של 92 אחוזי כיסוי
על פי דיווח ב-SD Times, הפופולריות של כיסוי קוד מובנת לחלוטין. הוא מספק תשובה אובייקטיבית וקלה למדידה לשאלה חשובה: אילו חלקים באפליקציה הופעלו במהלך הבדיקה? המידע הזה בעל ערך אדיר. הוא חושף נתיבי קוד שלא נבדקו ומעודד מפתחים לכתוב בדיקות בשלב מוקדם יותר.
הבעיה מתחילה כאשר ארגונים מתייחסים לכיסוי כפרוקסי לאיכות התוכנה עצמה. כיסוי קוד אומר לנו שהקוד בוצע. הוא לא יכול להגיד לנו אם הבדיקות מאמתות התנהגות עסקית משמעותית, אם הן אמינות, או אם הן יזהו פגם אמיתי שיוכנס למערכת מחר בבוקר. ביצוע וביטחון הם מושגים קשורים, אבל הם ממש לא אותו הדבר.
דמיינו שני פרויקטים ששניהם מדווחים על 92% כיסוי קוד. על הנייר, שניהם נראים בדוקים היטב. במציאות, הפרויקט הראשון מורכב מבדיקות מבודדות ודטרמיניסטיות שרצות באופן עקבי, עם אימותים (Assertions) שבודקים היגיון עסקי אמיתי. הפרויקט השני מכיל בדיקות כפולות, תלוי בזמן הנוכחי של השרת, ומשתמש באובייקטים מזויפים (Mocks) שמעולם לא הופעלו באמת. שניהם עומדים על 92%, אבל כל CTO יודע איזה קוד הוא מעדיף לתחזק.
הפתרון: מעבר מכיסוי קוד לאיכות בדיקות תוכנה
הפתרון: מעבר מכיסוי קוד לאיכות בדיקות תוכנה
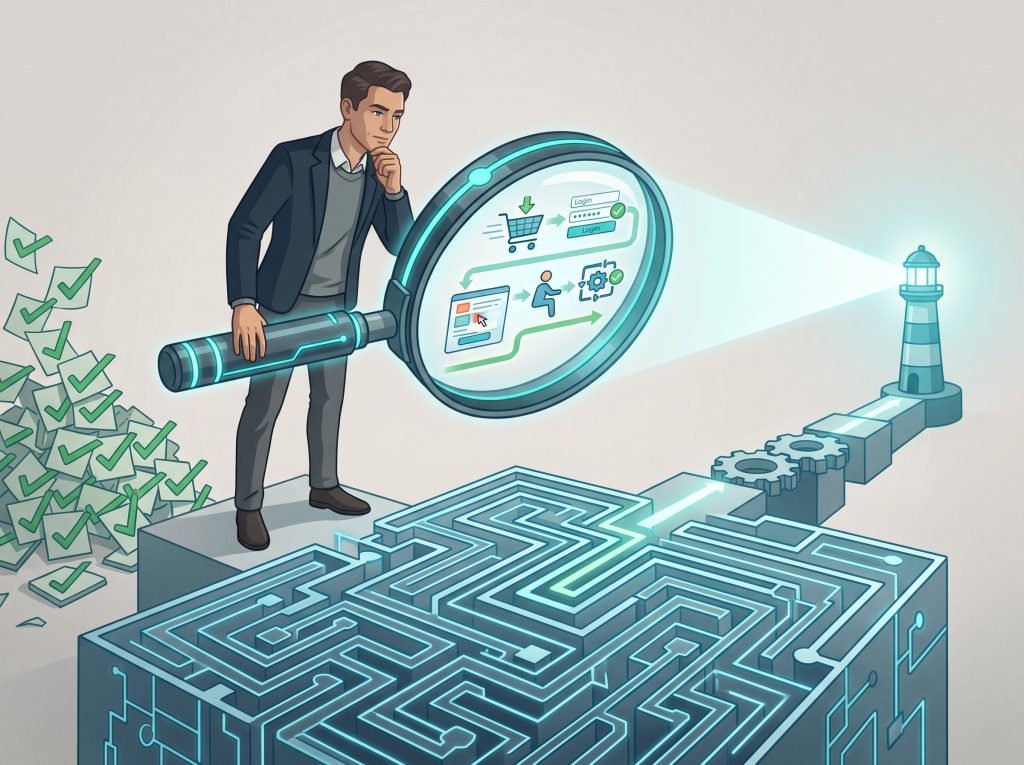
ההבנה שכיסוי הוא כלי אבחון ולא מטרה, היא השלב הראשון. השלב השני הוא אימוץ אסטרטגיית בדיקות מבוססת התנהגות ל-CTO ולצוותי הפיתוח. המשמעות היא שהמיקוד עובר מהשאלה "האם השורה הזו רצה?" לשאלה "האם התרחיש העסקי הזה עובד כמצופה?".
בעידן שבו כלי בינה מלאכותית יכולים לייצר מאות שורות של בדיקות אוטומטיות בשניות, קל מאוד להגיע לכיסוי מלא. מודלי שפה מצטיינים בלכתוב קוד שמפעיל פונקציות. אבל שיפור איכות בדיקות תוכנה בעידן ה-AI מחייב אותנו לבדוק את איכות האימותים שהמכונה או המפתח האנושי כתבו.
בדיקה טובה מוכיחה שהמערכת מתנהגת נכון תחת תנאים ספציפיים. בדיקה גרועה פשוט מריצה את הקוד כדי לסמן וי. הפתרון דורש הטמעת כלים שמנתחים את איכות הבדיקה עצמה, ולא רק את מסלול הריצה שלה.
ניתוח עמוק: אנטומיה של כיסוי ובדיקה
כדי להבין לעומק את הפער, צריך להכיר את 7 הסוגים השונים של כיסוי קוד הקיימים בתעשייה: כיסוי פונקציות, שורות, הצהרות, החלטות (ענפים), תנאים, כיסוי תנאים מרובים (MCC), וכיסוי תנאים והחלטות משתנה (MC/DC).
רוב הארגונים מסתכלים על כיסוי שורות. זהו המדד הבסיסי והמטעה ביותר. שורה יכולה לרוץ, אבל התנאי המורכב שבתוכה אולי נבדק רק חלקית. לעומת זאת, כיסוי ענפים או MC/DC מספקים תמונה מדויקת יותר של יסודיות הבדיקה. הם מוודאים שכל החלטה לוגית בקוד נבדקה גם לחיוב וגם לשלילה.
כלים מתקדמים כמו SonarQube משלבים דוחות כיסוי כדי להמחיש פערים ולאכוף ספי כיסוי באמצעות שערי איכות (Quality Gates). אבל גם כאן, השער ירוק אם המספר גבוה. הוא לא יודע להעריך אם ה-Assert בסוף הבדיקה אכן בודק את התוצאה של פונקציית ה-DiscountService, או שהוא פשוט בודק ש-1 שווה 1.
ופה בדיוק הבעיה: כשאנחנו מתגמלים מפתחים על אחוזים, אנחנו מקבלים אחוזים. אנחנו לא בהכרח מקבלים איכות.
תרחישים מהשטח שבהם הכיסוי משקר
כדי להמחיש איך למדוד ביטחון בבדיקות תוכנה אוטומטיות, בואו נבחן שלושה מקרי בוחן נפוצים שבהם מדד הכיסוי מציג תמונה ורודה, בזמן שהמוצר קורס:
1. הבדיקה הריקה (The Empty Test)
בתרחיש זה, מפתח כותב טסט שמאתחל אובייקט מורכב, קורא לפונקציה המרכזית, אבל שוכח או נמנע מלכתוב פקודת Assert משמעותית בסוף. הקוד של המערכת רץ במלואו, הכיסוי עולה, אבל הבדיקה לא מוכיחה שום דבר לגבי התוצאה. אם מישהו ישבור את הלוגיקה העסקית מחר, הבדיקה עדיין תעבור בהצלחה.
2. הבדיקה השברירית (The Fragile Test)
אפליקציה שמציגה 100% כיסוי, אבל הבדיקות תלויות בחיבור למסד נתונים חיצוני או משתמשות בתאריך קשיח. כשהרשת איטית או כשהשנה מתחלפת, הבדיקות נכשלות. צוותי פיתוח מתחילים להתעלם מהכישלונות האלה כי "זה רק הטסטים הקבועים שנופלים". האמון במערכת הבדיקות קורס, למרות שהכיסוי נשאר מושלם.
3. הבדיקה הכפולה (The Duplicate Test)
מערכת שמכילה עשרות בדיקות שמעבירות בדיוק את אותם נתונים דרך אותם נתיבי קוד, רק עם שמות שונים של פונקציות טסט. הכיסוי נראה יציב, אבל בפועל, מקרי קצה קריטיים – כמו חלוקה באפס, ערכי Null, או קלטים לא חוקיים – נשארים מחוץ לתחום.
התובנה המרכזית: כלי אבחון, לא תעודת ביטוח
התובנה המרכזית: כלי אבחון, לא תעודת ביטוח
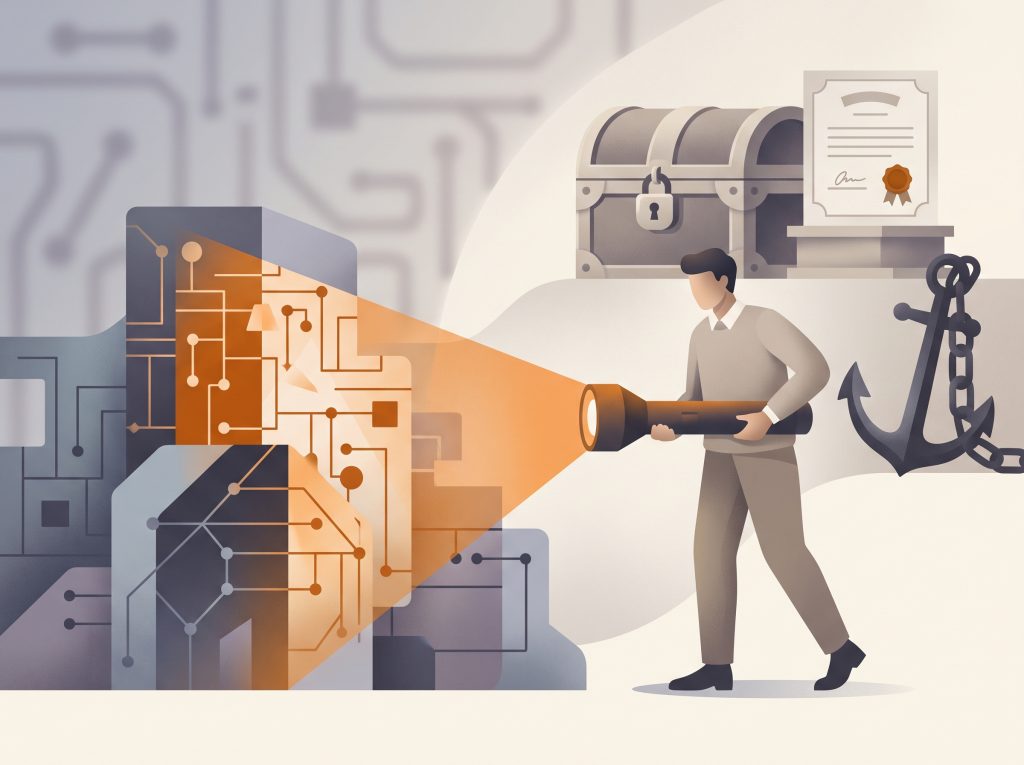
האסימון נופל כשמבינים שכיסוי קוד אינו תעודת ביטוח, אלא פנס. הוא מצוין בלהאיר את הפינות החשוכות של המערכת ולהראות לכם איפה מעולם לא ביקרתם. אבל הוא לא יכול להגיד לכם שום דבר על איכות הבנייה של החדרים המוארים.
ברגע ש-CTO או מנהל פיתוח מפנים את זה, השיח משתנה. הדרישה עוברת מ-"תגיעו ל-80% עד סוף הספרינט" ל-"תוודאו שתהליך התשלום בקופה מגובה בבדיקות דטרמיניסטיות שאי אפשר לשבור בטעות". זהו שינוי תפיסתי שחוסך מאות שעות של דיבוג בייצור.
היתרונות של התמקדות בביטחון
כאשר ארגונים עושים את המעבר הזה, התוצאות מורגשות מיד בשטח:
- ירידה בבאגים בייצור: בדיקות שבודקות התנהגות תופסות תקלות אמיתיות לפני שהן מגיעות ללקוח.
- תחזוקה קלה יותר: קל יותר לתחזק סט קטן של בדיקות איכותיות מאשר לתחזק אלפי בדיקות שבריריות שנכתבו רק כדי להעלות אחוזים.
- אמון הצוות: כשטסט נכשל, המפתחים יודעים שיש בעיה אמיתית בקוד, ולא מתעלמים מההתראה.
- שילוב AI נכון: שיפור איכות בדיקות תוכנה בעידן ה-AI הופך לאפקטיבי, כי הצוות יודע לכוון את הכלים האוטומטיים לייצר אימותים חכמים ולא רק להריץ קוד ריק.
מתי התמקדות בהתנהגות היא טעות: הצד השני של המטבע
מתי התמקדות בהתנהגות היא טעות: הצד השני של המטבע
למרות כל האמור לעיל, ישנם מצבים שבהם דרישה לניתוח התנהגותי עמוק לכל בדיקה היא שגיאה אסטרטגית. מתי כיסוי קוד בסיסי הוא בדיוק מה שאתם צריכים?
כאשר ארגון יורש מערכת מונוליתית ישנה (Legacy System) בת עשור, ללא שורת בדיקה אחת, הדרישה לכתוב מיד בדיקות התנהגותיות מורכבות היא מתכון לשיתוק. במקרה כזה, המטרה הראשונית היא פשוט להבין מה קורה בקוד. יצירת רשת ביטחון בסיסית שמגיעה ל-50% כיסוי שורות, אפילו עם בדיקות שטחיות יחסית, היא קריטית לפני ביצוע רפקטורינג (Refactoring) משמעותי.
במצבים אלו, התמקדות יתר באיכות האימותים תעכב את שחרור הצוות מהפחד לגעת בקוד. לפעמים, לדעת שהקוד פשוט לא קורס בזמן ריצה זה המסד שעליו בונים מאוחר יותר את הבדיקות האיכותיות.
משמעויות פרקטיות: מה לעשות מחר בבוקר
אם אתם מנהלים טכנולוגיים, יזמים או מובילי חדשנות, יש כמה צעדים קונקרטיים שניתן ליישם באופן מיידי:
- הפסיקו לתגמל על אחוזים: הסירו את היעד הנוקשה של 100% כיסוי. קבעו רף הגיוני (למשל 70-80%) והתמקדו במה שקורה בתוכו.
- הטמיעו Mutation Testing: כלי שמשנה בכוונה את קוד המקור שלכם ובודק אם הבדיקות נכשלות. אם הקוד השתנה והבדיקה עדיין עברה – הבדיקה שלכם חסרת ערך.
- סקרו את ה-Assertions: בצעו Code Reviews שמתמקדים בחלק האחרון של הבדיקה. האם אימתנו את התוצאה הנכונה? האם בדקנו מקרי קצה?
- הנחו את כלי ה-AI: אל תבקשו מ-Copilot "לכתוב טסטים לקלאס הזה". בקשו ממנו "לכתוב טסטים שמוודאים את ההיגיון העסקי של חישוב ההנחה, כולל טיפול בערכים שליליים".
נקודות מפתח לקחת הלאה
- כיסוי קוד מודד ביצוע, לא ביטחון ולא איכות.
- אחוז כיסוי גבוה יכול להסתיר בדיקות ריקות, שבריריות או כפולות שאינן תורמות ליציבות המוצר.
- יש להבדיל בין כיסוי שורות פשוט לבין כיסוי ענפים ותנאים מורכבים שמספקים תמונה אמינה יותר.
- השתמשו בכיסוי כפנס כדי למצוא קוד שלא נבדק, ולא כמדד להערכת ביצועי מפתחים.
בעולם שבו טכנולוגיות מתפתחות בקצב מסחרר ומערכות הופכות למורכבות יותר ויותר, אי אפשר להסתמך על מדדי רהב. אם אתם יזמים, מנהלי חדשנות או סמנכ"לי טכנולוגיה המחפשים שותף טכנולוגי לפיתוח מוצרים דיגיטליים מתקדמים, ודאו שהשותף שלכם מבין את ההבדל בין קוד שרץ לקוד שעובד. השקעה באסטרטגיית בדיקות חכמה היום, תחסוך לכם משברים יקרים מול הלקוחות שלכם מחר.
שאלות ותשובות
כיסוי קוד הוא מדד טכני המציין אילו שורות קוד הופעלו במהלך הרצת הבדיקות, בעוד שאיכות בדיקות תוכנה מודדת את רמת הביטחון שהמערכת מתנהגת כמצופה. כיסוי קוד עונה על השאלה 'האם הקוד רץ?', אך הוא אינו מעיד על כך שהלוגיקה העסקית נבדקה או שהבדיקה מסוגלת לזהות באגים אמיתיים. בדיקה איכותית מתמקדת באימות התנהגות (Assertions) ומוודאת שהמערכת מגיבה נכון לתרחישים שונים, כולל מקרי קצה. בעוד שכיסוי קוד הוא כלי אבחון שימושי לזיהוי אזורים לא מנוצלים, הוא אינו מהווה מדד אבסולוטי ליציבות המוצר או לחסינותו מפני תקלות בייצור.
הגעה ל-100% כיסוי קוד מבטיחה שכל שורת קוד הופעלה, אך היא לא מבטיחה שהקוד נבדק לעומק. ניתן להגיע לכיסוי מלא גם עם בדיקות שאין בהן אימותים (Assertions) משמעותיים, או עם בדיקות שבריריות שתלויות בגורמים חיצוניים משתנים. אם הבדיקות רק מריצות את הפונקציות מבלי לוודא את התוצאה העסקית, הן לא יזהו שגיאות לוגיות או התנהגות לא צפויה. בנוסף, כיסוי קוד לא בודק אינטראקציות מורכבות בין רכיבים שונים או תרחישי קצה שאינם מוגדרים במפורש בקוד. לכן, אחוז גבוה הוא לעיתים אשליה שיוצרת תחושת ביטחון כוזבת אצל מנהלים וצוותי פיתוח.
שיפור איכות הבדיקות בעידן ה-AI דורש מעבר ממיקוד בכמות הבדיקות למיקוד באיכות האימותים. כלי בינה מלאכותית מסוגלים לייצר מאות בדיקות בשניות, אך הם עלולים לייצר קוד שרק מפעיל פונקציות ללא בדיקת היגיון עסקית. כדי להפיק ערך, יש להנחות את כלי ה-AI לייצר בדיקות שבודקות תרחישים ספציפיים, מקרי קצה וערכים לא חוקיים. בנוסף, חשוב לבצע סקירה אנושית על ה-Assertions שה-AI מייצר כדי לוודא שהם אכן בודקים את התוצאה הרצויה. המטרה היא להשתמש ב-AI ככלי עזר לייצור תשתית בדיקות חכמה, ולא כפתרון קסם שפוטר את הצוות מהבנת הלוגיקה העסקית.
בדיקות שבריריות הן בדיקות שנכשלות לעיתים קרובות בגלל גורמים שאינם קשורים לבאג בקוד, כמו תלות במסד נתונים חיצוני, זמני תגובה של רשת או תאריכים קשיחים. הסיכון המרכזי הוא שחיקת אמון הצוות במערכת הבדיקות; כאשר מפתחים מתרגלים לראות בדיקות שנכשלות ללא סיבה מוצדקת, הם מתחילים להתעלם מהתראות גם כשמדובר בבאג אמיתי. תופעה זו הופכת את מערך הבדיקות לנטל תחזוקתי יקר שאינו מספק הגנה אמיתית. במקום להוות רשת ביטחון, בדיקות שבריריות יוצרות רעש מיותר ומעכבות את תהליך הפיתוח והשחרור של גרסאות חדשות.
השקעה בכיסוי קוד בסיסי מתאימה בעיקר בעבודה עם מערכות Legacy ישנות שאין להן כלל בדיקות אוטומטיות. במצבים אלו, ניסיון לכתוב בדיקות התנהגותיות מורכבות עלול להוביל לשיתוק של צוות הפיתוח ולפחד מביצוע שינויים בקוד. יצירת רשת ביטחון בסיסית, גם אם היא כוללת בדיקות שטחיות המגיעות ל-50% כיסוי, מאפשרת לצוות לבצע רפקטורינג (Refactoring) בסיסי בביטחון רב יותר. לאחר שהמערכת יציבה יותר וקיימת תשתית בסיסית, ניתן להתחיל לשדרג את הבדיקות לרמה התנהגותית עמוקה יותר. המטרה הראשונית היא להפחית את הפחד מהקוד ולא להגיע לשלמות בדיקתית בבת אחת.
Mutation Testing הוא טכניקה מתקדמת שבה המערכת משנה בכוונה חלקים מקוד המקור (למשל, הופכת סימן 'גדול מ' ל-'קטן מ') ובודקת אם הבדיקות הקיימות מזהות את השינוי. אם הבדיקה עדיין עוברת בהצלחה למרות שהקוד שונה, סימן שהבדיקה אינה איכותית מספיק ולא בודקת את הלוגיקה בצורה נכונה. כלי זה מספק אינדיקציה אובייקטיבית לחוזק של סט הבדיקות שלכם. הוא עוזר לגלות בדיקות 'ריקות' או כאלו שאינן בודקות את התוצאה הנכונה, ובכך מאפשר לצוות להתמקד בשיפור הבדיקות הקיימות במקום רק להוסיף עוד ועוד בדיקות חסרות ערך.
הקצאת משאבים לשיפור איכות הבדיקות צריכה להיעשות כחלק אינטגרלי מתהליך הפיתוח ולא כפרויקט נפרד. במקום להקדיש זמן מוגדר מראש, מומלץ להטמיע תרבות של Code Review שמתמקדת בבדיקות, ולהנחות את הצוותים לכתוב בדיקות דטרמיניסטיות כחלק מהגדרת ה-Definition of Done. העלות של השקעה בבדיקות איכותיות נמוכה משמעותית מהעלות של תיקון באגים בייצור או תחזוקת אלפי בדיקות שבריריות. ככל שהצוות מיומן יותר בכתיבת בדיקות ממוקדות התנהגות, כך הזמן המושקע בדיבוג יורד, מה שמוביל לחיסכון משמעותי בזמן ובמשאבים בטווח הארוך.